文章 11AI 时代的组织与管理
拆掉我和 Agent 协作中的那块短木板
借模型升级的机会,我审了一遍用了三个月的 AI 工作体系:理清互相冲突的规则,精简多余流程,也保留仍然有效的工具约束。AI 进步很快的时代,别让旧体系变成你和 AI 协作中最短的那块木板。
English version
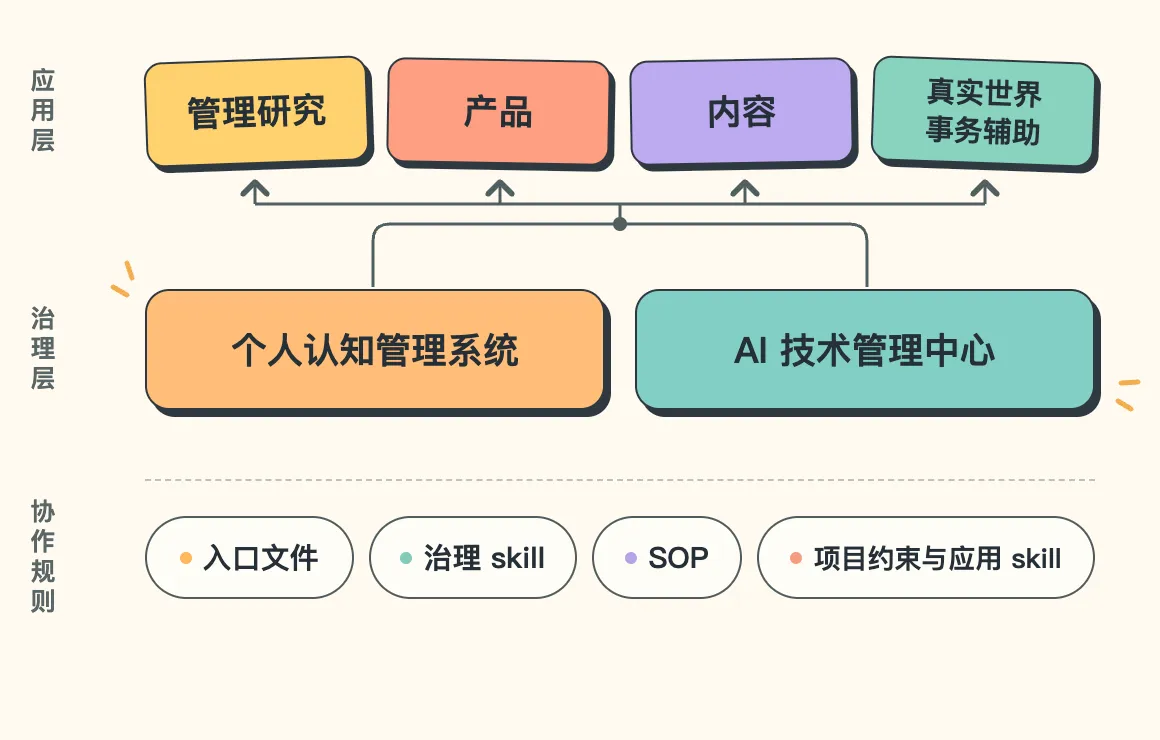
我目前的这版 AI 工作体系跑了三个月,设了两个底层项目:一个是个人认知管理系统,负责个人复盘、自我理解和决策辅助;一个是 AI 技术管理中心,负责 AI 技术层的底层治理和持续探索。上面跑着各个应用项目,做管理研究、做产品、做内容、做真实世界各类事务辅助。这些项目通过几类规则配合:入口文件告诉 Agent 进项目先读什么,一个治理 skill 管理各 skill 的创建、维护归属和验收,SOP 存具体做法,项目里再放各自的业务约束和应用级 skill。
最近 Codex 用上了新模型,试用了几天,确实感觉它更守规矩、更会自己推理。
刚好看到官方开发者 Eric Provencher 在《为 GPT-6 Astra 重新审视 skill 和提示词》中提出的建议:借模型升级重新检查积累下来的指令。过去需要详细步骤引导的工作,新模型可能已经能自主处理,继续限定路线反而可能影响结果。他列了几个检查点:触发描述还准不准、资料该不该按需展开、过度指定的流程要不要重检、阅读和测试是不是该按任务来、边界和完成条件清不清楚、有没有考虑不同模型的差异。
所以借这个契机,结合最近一段时间的项目实践,给自己的 AI 体系做一次全面审计。看看哪些旧要求还有必要保留,哪些已经可以调整。
审计中发现的几个典型问题,都落在同一条工作链上:一个项目需要新建 skill 时,怎样判断是否值得建,由谁维护,需要经过哪些步骤、读取哪些材料。
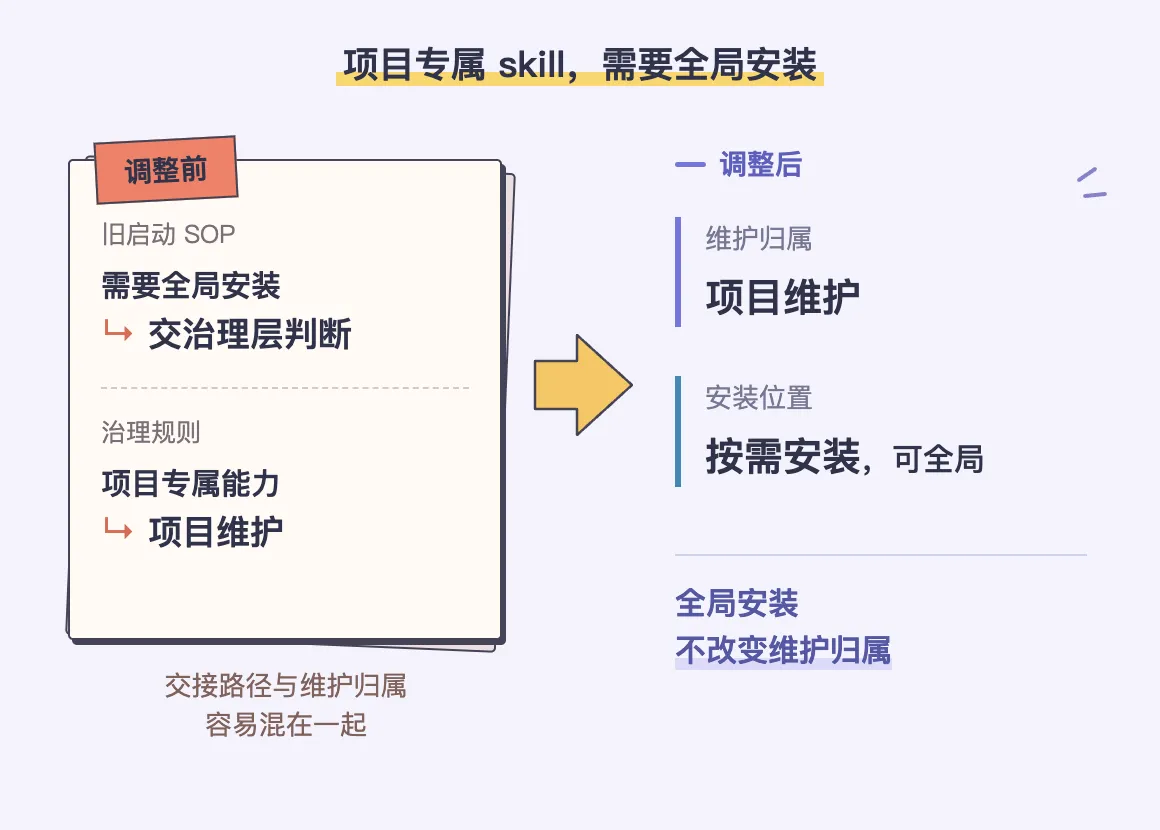
问题出在两条规则对不上。一条是管 skill 创建之后怎么交接的启动 SOP,它把 skill 需要全局安装的情况,列为交给治理层的 AI 技术管理中心判断的一个条件;另一条治理规则却又规定,项目专属的 skill 归项目维护。于是,一个项目专属的 skill 要是需要全局安装,按前一条会被引到治理层,按后一条该留在项目,归属的理解和交接路径就岔开了。这可能多出不必要的交接,也让 Agent 难以判断该由谁处理。
这条工作链的前置要求也偏重。建一个 skill,先要过计数门槛:同类任务出现规定次数后才进候选,达标后先写 brief,再生成一份候选交接包。这些规定各有来历,设立时都是根据当时踩的坑和复盘经验而来,为的是少做人工搬运、让创建更稳、把归属理清。可叠在一起,就把本来可以很短的事拉成了一条长流程。
本轮做的,是把这条链上的冲突和多余步骤重新理一遍:
- 把“能力归谁维护”和“副本装在哪里”拆成两件事:项目专属的能力,装到哪都归项目维护。
- 根据复杂度和牵涉面分级处理:简单的调整直接完成;归属不清、基础与应用能力耦合,或权限不足、确实需要另一方处理时,再走交接。
- skill 该不该创建,先看它补的是什么缺口:相对现有模型、项目文档、现有 skill 有没有增量价值。高频、稳定这些信号留着当参考,不再是准入门槛。
前面那个专门管 skill 创建、维护和验收的治理 skill,自己也被收敛了一遍。原来有 276 行,从先判断这个 skill 有没有必要开始,到八步设计流程、最小结构、分工检查、验收清单,一步步铺开。
精简完剩 60 行,收敛成四类:这个 skill 补什么缺口、归谁维护、写的时候做哪些取舍、改完怎么验收。具体的格式与基础校验继续由现有 skill-creator 处理,治理 skill 不再要求每次先走完同一套八步流程。例如,原来的“先写 brief”,改成简单任务直接使用已有上下文,复杂设计才按需参考模板。
从 276 行缩减到 60 行,文件行数减少了约 78%,每次加载时需要带入的指令也精简了许多。而且收敛掉的是那些过度指定的步骤;真正靠得住的工具限制,没有因为短就丢掉。
给 Agent 的入口也一并改了。以前 Agent 进一个项目,默认先把入口文件、项目背景、README 全读一遍;现在改成按任务补读,当前缺什么读什么,读过又没变的不重复通读。
审计也不是一直在删。
录音审校的规则里就有一条,规定配音分段每段 200 到 300 字,可录音生产规则里早把上限改掉了,这条审校规则就成了过期数据。这次没直接删它,改成让它引用生产规则的权威参数,不再单独维护一份数字。
录音生产和审校是各自独立的环节,都需要有自己的流程管控,审校时按需查阅生产规则里的参数即可,不必把整套生产规则内容重读一遍。新模型再会推理,配音工具的对接限制也不会跟着消失。所以这类约束该留就留,但同样的参数只放一处,其他地方只做引用,避免多处维护产生冲突。
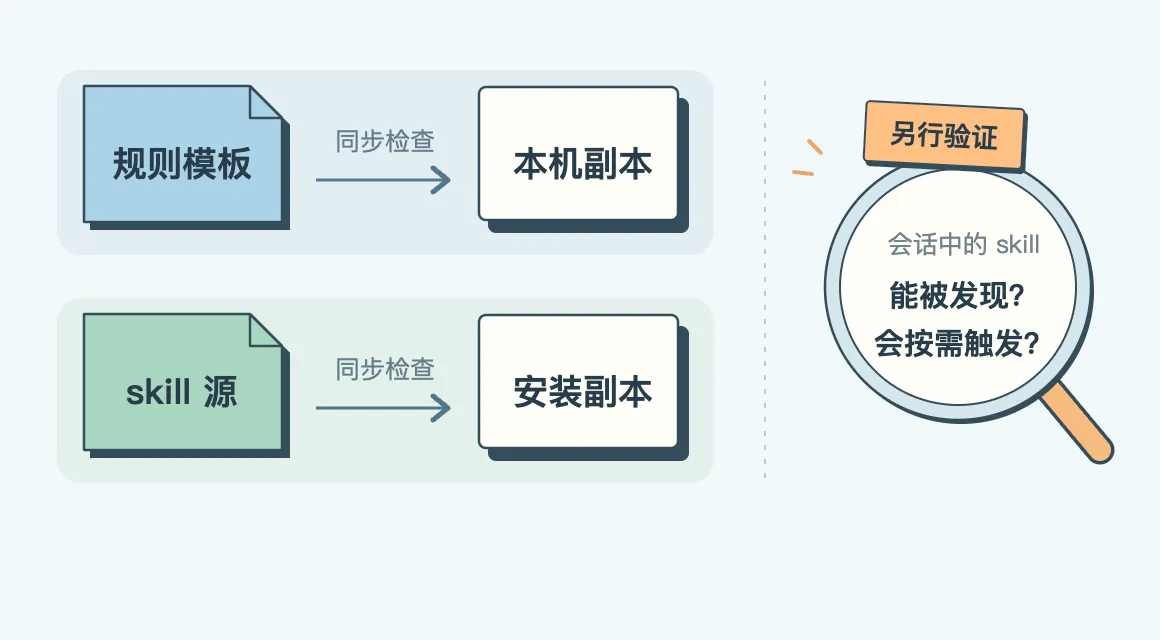
改完文件,事情还没完。体系里的规则有几个落点:AI 技术管理中心里维护的源文件已经更新,本地系统环境安装的副本也需要同步更新,Agent 能不能在需要的时候找到并调用也要另外验证。
所以要跟着一个检查环节:本地链接有没有失效,skill 的基础校验过不过,改了创建规则会不会误伤别的调用。
最后,让一个独立 Agent 来测试,只给它最小上下文、不提前给出预期答案,去测四个合成请求:偶发任务要不要建 skill、项目专属的 skill 全局安装后归谁维护、别的 Agent 的写入边界在哪、模型升级和生产工具约束怎么区分。四个请求都守住了该守的阶段和权限。
这些是文档和样例层面的验证。真实任务里能省多少工作,还要等后面的实际任务来验。
除了简化掉多余步骤,我也重新明确了希望 AI 怎样参与工作。
过去我定过一条原则:人带框架来,AI 填血肉;人不带框架来,AI 只能猜。当时认为自己得先把问题想清楚、把框架搭好,AI 才有用武之地。
这次把限制也放宽松了,现在我可以带着一个疑问、一个没想明白的问题开始,让 AI 一起去搭框架、补全、找反例、提更好的路。问题的定义可以一起探索,最终的价值取舍和方向控制在我手里。
审计并调整后,其实还有一个长期问题:怎样让规则能够持续跟上实际工作的变化。定期审计是个办法,但万一我懒了或是忙的时候忘了,很多新坑可能就又埋进去了。
所以这次同时立了一条分级维护的 SOP,把维护分成轻、中、核心三档:改个别规则算轻度,改一个项目的完整协作链算中度,动全局原则或架构算核心级。可以按需要主动发起,也让 Agent 在模型升级、阶段复盘或反复卡壳时提醒我检查。
全部完事儿后回看,这次审计和重构让体系重新匹配上现在的 AI,也匹配上了现在的我。
Agent、skill、SOP 都在跟着变,有两个方向:加法是学新技能、立新规矩;减法是回头看看旧的还有没有用,让已经多余的补丁退场。这次重心放在了后者。
AI 跑得很快,大模型的能力提升得很快,你的应用经验和认知也会变得很快。这时就别让旧体系变成你和 AI 协作中最短的那块木板。